CLAUDE
Wat is een agent harness (en waarom Claude Code er een is)?
Een agent harness is alles om een LLM heen: tools, memory, systeemprompt. Ontdek waarom de harness belangrijker is dan het model, met Claude Code als voorbeeld.
2026 · 04 · 116 MIN
Leer hoe parallellisatie in Claude Code je workflow versnelt. Vier redenen om meerdere agents tegelijk in te zetten, met concrete berekeningen en tips.
 Emiel Kolk9 MIN LEZEN
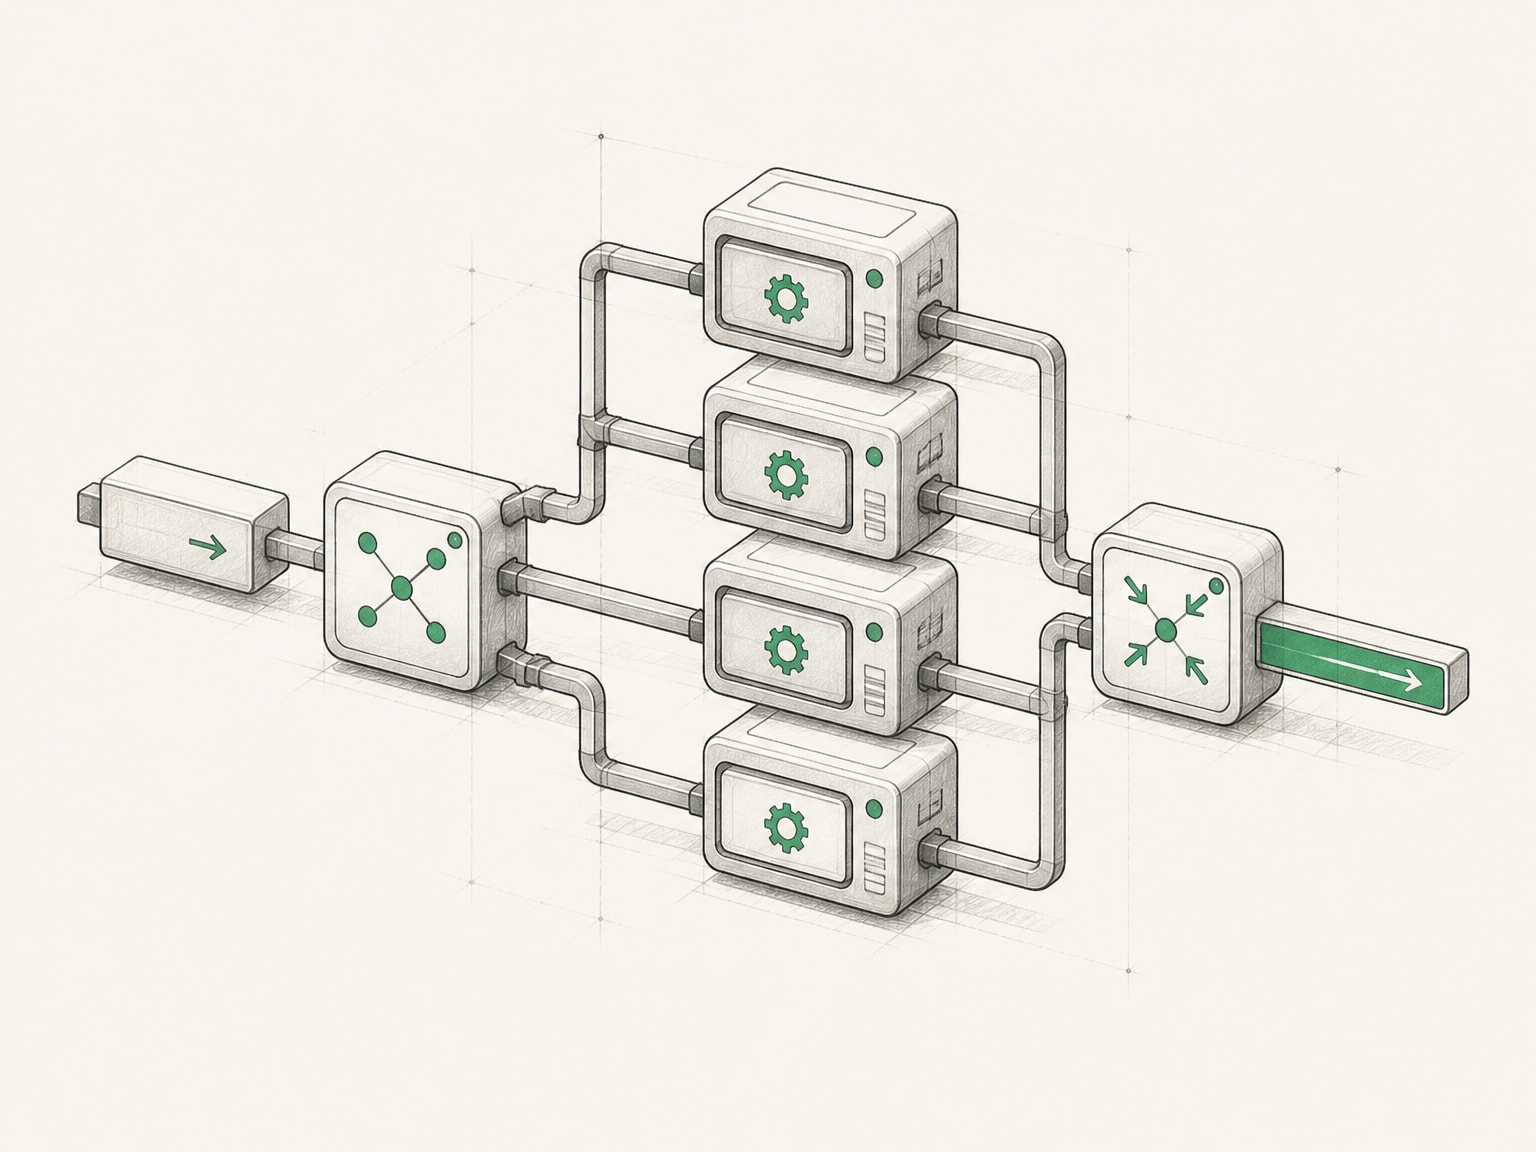
Heb je weleens een opdracht aan Claude Code gegeven en vervolgens vijf minuten naar je scherm zitten staren? Dat is de realiteit van sequentieel werken: je wacht tot stap één klaar is voordat stap twee begint. Parallellisatie lost dat op. In plaats van taken achter elkaar af te handelen, zet je meerdere agents tegelijk in. Het resultaat: dezelfde output in een fractie van de tijd.
In dit artikel leg ik uit wat parallellisatie precies inhoudt, waarom het om vier redenen slim is, en hoe je het praktisch inricht met Claude Code sub-agents.
Parallellisatie betekent dat je meerdere taken tegelijkertijd laat uitvoeren in plaats van na elkaar. In de context van Claude Code betekent dit: je laat sub-agents los op verschillende onderdelen van een probleem, terwijl de hoofd-agent de regie houdt.
Stel je voor dat je een contentmanager bent bij een bureau met 12 klanten. Je wilt voor elke klant een concurrentieanalyse draaien. Sequentieel kost dat 12 keer 4 minuten, oftewel 48 minuten wachten. Met parallellisatie draai je alle 12 analyses tegelijk en heb je na 4 minuten alles in huis.
Het basispatroon heet fan-out/fan-in:
Dit patroon is niet nieuw. Het is hoe fabrieken werken, hoe keukens in restaurants werken, en hoe softwareteams al decennia parallel ontwikkelen. Het verschil: met AI-agents kan je het toepassen op kenniswerk.
De eerste reden is de meest voor de hand liggende: tijdsbesparing. Maar de berekening is concreter dan de meeste mensen denken.
Neem een praktijkvoorbeeld. Je wilt een blogartikel produceren met deze stappen:
Sequentieel duurt dit 4 + 5 + 3 + 8 = 20 minuten.
Maar stap 1, 2 en 3 zijn onafhankelijk van elkaar. Die kan je parallelliseren. Stap 4 heeft de resultaten van de eerste drie stappen nodig, dus die blijft sequentieel.
Parallel duurt dit max(4, 5, 3) + 8 = 13 minuten. Dat is 35% tijdswinst.
Bij grotere workflows wordt het verschil dramatischer. Een contentmanager die wekelijks 5 artikelen produceert, bespaart met parallellisatie al snel 30+ minuten per week. Tijd die je kunt besteden aan de dingen die wél je aandacht nodig hebben.
De tweede en derde reden gaan niet over snelheid, maar over kwaliteit.
Elke sub-agent start met een schone context. Dat klinkt als een detail, maar het maakt een groot verschil. Wanneer je alles sequentieel door één agent laat doen, groeit het context window met elke stap. De agent moet de output van stap 1 meenemen naar stap 2, en de output van stap 1 en 2 naar stap 3. Tegen de tijd dat je bij stap 4 bent, zit de context vol met informatie die niet relevant is voor die specifieke taak.
Met parallellisatie krijgt elke sub-agent alleen de instructie en context die relevant is voor zijn deeltaak. De keyword-research-agent hoeft niets te weten over de concurrentieanalyse. En dat levert betere output op.
Dit sluit aan bij het principe van tokenkosten besparen: minder irrelevante tokens in de context betekent betere resultaten.
AI-agents zijn stochastisch. Dat betekent dat ze niet altijd hetzelfde antwoord geven op dezelfde vraag. Meestal is dat een nadeel. Maar bij parallellisatie kan je het omdraaien tot een voordeel.
Stel dat je drie sub-agents dezelfde concurrentieanalyse laat doen. Elke agent kiest een net iets andere invalshoek, benadrukt andere patronen, of vindt andere inzichten. Een synthesizer-agent combineert vervolgens de drie analyses tot één resultaat dat rijker en completer is dan wat één agent alleen had geproduceerd.
Dit patroon heet majority voting of best-of-N sampling. Je laat meerdere agents dezelfde taak uitvoeren en kiest het beste resultaat, of je combineert de sterke punten van alle resultaten. Het is duurder in tokens, maar de kwaliteitsverbetering is meetbaar.
De vierde reden is technisch, maar cruciaal. Elk taalmodel heeft een context window: het maximale aantal tokens dat het tegelijk kan verwerken. Hoe voller dat window, hoe slechter het model presteert. Onderzoek laat zien dat LLMs informatie in het midden van een lang context window systematisch over het hoofd zien (het zogenaamde "lost in the middle"-probleem).
Bij een lange sequentiële workflow groeit je context window met elke stap. Na vijf of zes stappen zit je al snel op tienduizenden tokens. De agent begint subtiele fouten te maken, vergeet eerdere instructies, of genereert output die niet meer aansluit bij de oorspronkelijke opdracht.
Parallellisatie voorkomt dit probleem. Elke sub-agent werkt binnen zijn eigen, beperkte context. De synthesizer ontvangt alleen de eindresultaten, niet het volledige denkproces van elke sub-agent. Zo houd je de context compact en de output scherp.
Wil je begrijpen hoe je de agent harness van Claude Code inricht om dit goed te laten werken? Dat begint bij een goed CLAUDE.md systeemprompt per agent.
Nu het praktische gedeelte. Claude Code ondersteunt parallellisatie via sub-agents (ook wel "agent teams" genoemd). Zo werkt het:
Ga je workflow na en markeer welke stappen geen afhankelijkheden hebben. Stappen die elkaars output niet nodig hebben, kan je parallelliseren. Stappen die afhankelijk zijn van eerdere output, blijven sequentieel.
Een vuistregel: als je een stap kan uitleggen zonder te verwijzen naar het resultaat van een andere stap, is die stap onafhankelijk.
Maak voor elke parallelle taak een agent-definitie. In Claude Code doe je dit via het agents-blok in je CLAUDE.md of via een aparte agent-configuratie. Elke agent krijgt:
# Voorbeeld: agent definitie voor een research-agent
agents:
    - name: keyword-researcher
      description: 'Zoekt relevante keywords voor een gegeven topic'
      instructions: 'Analyseer het topic en lever een lijst van 10 keywords met zoekvolume-inschatting.'
    - name: competitor-analyst
      description: 'Analyseert top-3 concurrenten voor een keyword'
      instructions: "Vind de top-3 rankende pagina's, analyseer structuur en unieke invalshoeken."
De hoofd-agent (orchestrator) verdeelt het werk, start de sub-agents parallel, en wacht op de resultaten. Vervolgens voegt de orchestrator de output samen of stuurt deze door naar een synthesizer-agent.
Orchestrator
├── Sub-agent 1: Keyword research      ─┐
├── Sub-agent 2: Concurrentieanalyse    ─┤ parallel
├── Sub-agent 3: Doelgroepanalyse       ─┘
└── Synthesizer: Combineert resultaten     sequentieel
Dit is het fan-out/fan-in patroon in actie. De orchestrator doet de fan-out, de synthesizer doet de fan-in.
Een slimme toepassing: gebruik goedkope, snelle modellen voor de research-agents en reserveer het krachtigste model voor de synthesizer. De research-agents hoeven geen perfecte tekst te schrijven. Ze moeten informatie verzamelen. De synthesizer neemt die ruwe input en maakt er een coherent geheel van.
Dit bespaart tokens en geld, zonder in te leveren op kwaliteit. De dure tokens gaan naar de stap die er het meest toe doet.
Parallellisatie is geen wondermiddel. Er zijn situaties waarin sequentieel werken beter is.
Afhankelijke stappen. Als stap 2 de output van stap 1 nodig heeft, kan je ze niet parallelliseren. Forceer je het toch, dan werkt de sub-agent met ontbrekende context en krijg je slechte output.
Gedeelde state. Wanneer meerdere agents hetzelfde bestand moeten wijzigen, ontstaan conflicten. Twee agents die tegelijk dezelfde code aanpassen, produceren tegenstrijdige wijzigingen. Sequentieel is dan betrouwbaarder.
Simpele taken. Bij een taak van twee stappen die samen 3 minuten duren, is de overhead van het opzetten van sub-agents groter dan de tijdswinst. Parallellisatie loont pas bij workflows van 10+ minuten met minimaal drie onafhankelijke stappen.
Taken die iteratie vereisen. Het plan-instantiate-learn loop patroon werkt juist goed sequentieel, omdat elke iteratie leert van de vorige. Parallellisatie doorbreekt die feedbackloop.
Parallellisatie is geen geavanceerde techniek voor power users. Het is een fundamenteel patroon dat elke Claude Code-gebruiker kan toepassen zodra workflows langer worden dan een paar minuten.
De vier redenen om te parallelliseren:
Begin simpel. Kies een workflow die je regelmatig draait, identificeer de onafhankelijke stappen, en split ze op in sub-agents. De eerste keer kost het even om het op te zetten. Daarna draait het vanzelf.

Geschreven door
Emiel Kolk
CEO & AI-native software consultant
Emiel is gespecialiseerd in Growth Automation. Hij verkocht zijn SaaS bedrijf aan Leadinfo. Hij haalde meer dan 16.000 MKB bedrijven binnen, zonder er één handmatig te benaderen: 95% geautomatiseerd, 100% persoonlijke touch.
Bekijk profielCLAUDE
Een agent harness is alles om een LLM heen: tools, memory, systeemprompt. Ontdek waarom de harness belangrijker is dan het model, met Claude Code als voorbeeld.
CLAUDE
Leer hoe de plan-instantiate-learn loop je AI workflow iteratief verbetert. Elke sessie bouwt voort op de vorige, zodat Claude Code sneller en goedkoper werkt.
CLAUDE
Leer hoe je tokenkosten bespaart met kenniscompressie in CLAUDE.md. Van 827 woorden naar 22: een 45x compressie die kosten halveert en output verbetert.
Wij bouwen en beheren software voor een vast bedrag per maand. Begin met een gratis kennismaking van een half uur. Je hoort eerlijk of het past.